Pe 11 august 2026, la mai puțin de o zi după ce vestea că Anthropic urma să pună un marcaj pe textul scris cu Claude a ajuns în presă, pe GitHub a apărut watermarks-remover, un tool care promitea să șteargă marcajul. În 12 zile a strâns peste 17.000 de stele pe GitHub, iar în feed au început să curgă clipurile cu „comentează SKILL / WATERMARK și îți trimit ghidul”.
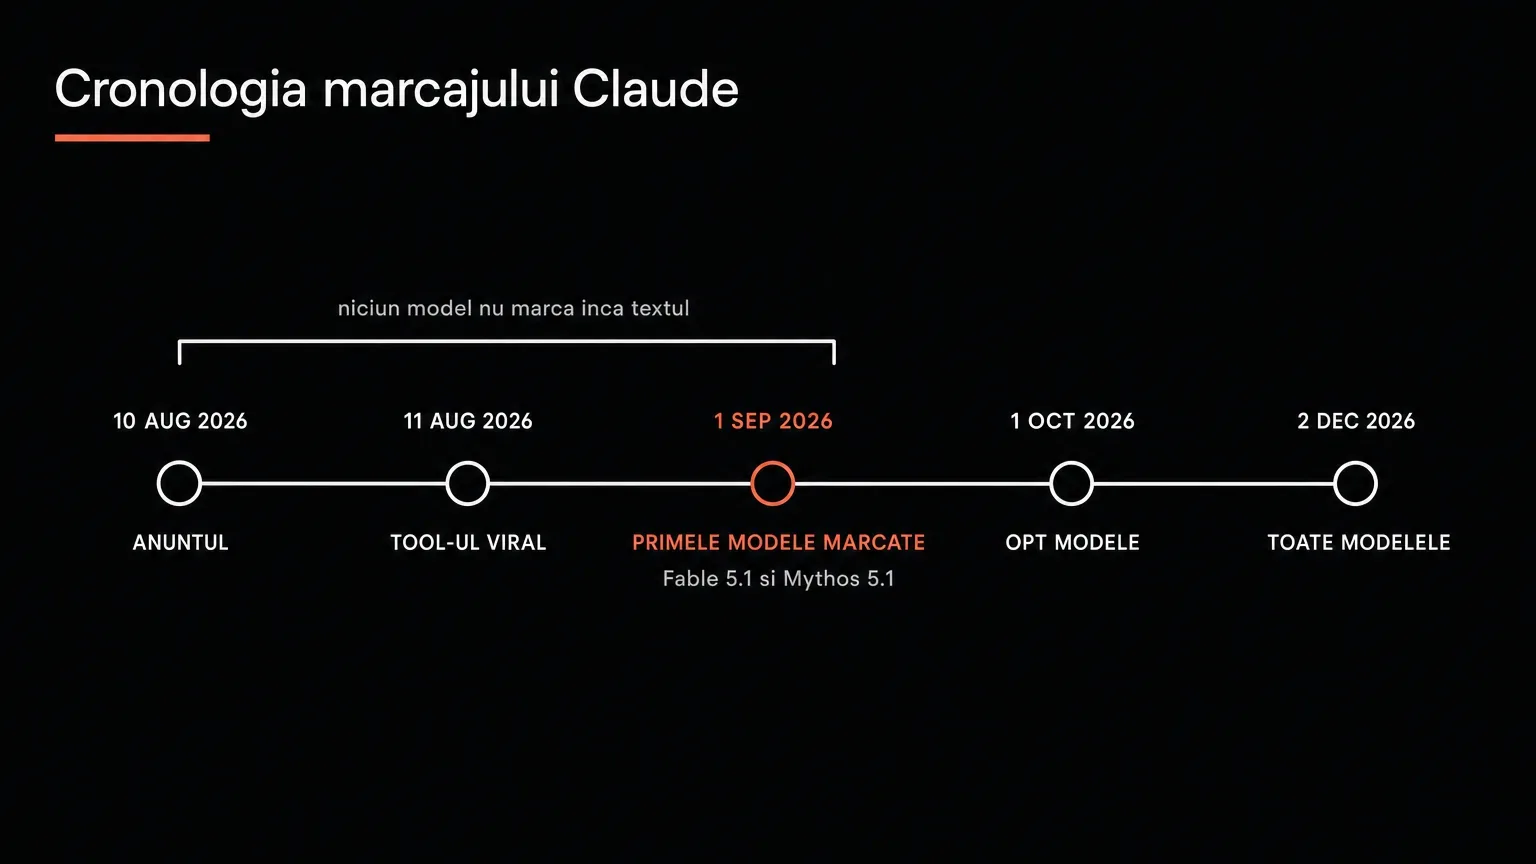
Conform documentației Anthropic, în august niciun model Claude nu marca încă textul. Primele modele care o fac, Claude Fable 5.1 și Claude Mythos 5.1, au apărut abia pe 1 septembrie. În stil clasic, tot valul de hype, cu tool-uri, tutoriale, titluri alarmiste și abonamente anulate în semn de protest, s-a învârtit în jurul unui marcaj care încă nu exista.
Totuși, asta nu înseamnă că ar trebui să ignorăm situația. La 1 octombrie, avem opt modele Claude care pun watermark pe text, pentru a se conforma AI Act, iar până la final de an le vor urma și restul. Pentru un marketer sau creator care scrie zilnic cu Claude, rămân următoarele întrebări: ce face de fapt acest watermark, cine îl poate citi, dacă merită șters și ce spune legea despre asta.
Pe scurt, Watermarkul Claude e un tipar statistic ascuns în alegerea cuvintelor, pe care îl pot citi doar Anthropic și câteva organizații eligibile. Nu conține date despre tine și arată doar că textul a trecut, probabil, prin Claude.
Dacă folosești vocea ta (personalizare) sau editezi textul la final, acea probabilitate ar trebui să scadă procentual, dar cam toate sursele susțin că de fapt impactul asupra marcajului va fi nesemnificativ. Watermark-ul poate fi șters doar printr-o rescriere aproape integrală, făcută de tine sau de alt model.
Vom vedea cum arată lucrurile în realitate atunci când apar teste publice. Între timp, am adăugat în acest articol toate nuanțele pe care le-am găsit pe subiectul Claude Watermark.
Ce marchează de fapt Claude watermark?
Watermarkul Claude e un tipar statistic în alegerea cuvintelor, pe care îl poate citi doar cine are cheia secretă a Anthropic. În text în sine nu se adaugă nimic, nici măcar caractere invizibile, iar marcajul nu conține date despre tine sau despre firma ta. Un marcaj găsit arată doar că textul a trecut, probabil, prin Claude la un moment dat.
Anthropic a anunțat marcajul pe 10 august, iar primele modele care îl pun pe text au apărut pe 1 septembrie. Între cele două date a încăput tot valul viral.
Pagina din centrul de ajutor, „How Claude marks AI-generated content”, a apărut luni, 10 august, seara pe ora României, și anunța marcarea textului pentru modelele lansate începând cu 2 august. A doua zi a preluat-o presa, de la TechCrunch la Euronews. Pagina nu spunea nimic despre mecanism, așa că timp de patru zile internetul s-a jucat de-a ghicitul.
O bună parte din internauți au presupus că watermarkul înseamnă caractere invizibile ascunse în text, iar o publicație americană de tech a scris chiar despre cod invizibil inserat în răspunsuri.
De asta unealta care curăța astfel de caractere a devenit virală super rapid.
Abia pe 14 august, această postare tehnică de la Anthropic a lămurit că marcajul nu adaugă nimic în text și nu folosește caractere ascunse. Prima ei frază vorbea tot la viitor, despre modelele Claude care vor genera text marcat.
Pe X, zeci de utilizatori anunțau între timp că renunță la abonament, dar Anthropic spunea pentru Business Insider că n-a văzut o creștere a anulărilor.
După ce s-au mai liniștit dramele online, a început partea acționabilă a situației.
Pe 1 septembrie au apărut Fable 5.1 și Mythos 5.1, primele modele care marchează textul, iar în aceeași zi Anthropic a deschis detectorul AI pentru un cerc restrâns de organizații. Au urmat Opus 5, marcat retroactiv la jumătatea lui septembrie, apoi Opus 5.5, lansat pe 22 septembrie, și Sonnet 5.5, pe 28 septembrie. Pe 1 octombrie au primit marcajul și Fable 5, Opus 4.8 și Sonnet 5. Modelele mai vechi primesc marcajul treptat, toate până pe 2 decembrie 2026, termenul pe care Digital Omnibus îl dă sistemelor generative aflate deja pe piață.
Cum funcționează marcajul
Marcajul decide, cu ajutorul unei chei secrete, alegerea dintre cuvintele pe care Claude le consideră la fel de bune.
La multe dintre cuvintele pe care le scrie, modelul are mai multe variante potrivite. În mod normal, alegerea este făcută de către un generator aleatoriu. Cu watermark, alegerea este decisă de către cheia Anthropic și câteva cuvinte dinaintea poziției respective. Cititorul vede același text „natural”, dar cine are cheia poate calcula ulterior cât de probabil e ca textul să fi trecut prin Claude.
Anthropic spune că folosește o variantă a SynthID-Text, tehnica publicată de Google DeepMind în Nature în octombrie 2024, cu care Google marchează textul din aplicația Gemini. Familia de metode pornește de la o propunere a lui Scott Aaronson din 2022, făcută pe vremea când lucra la OpenAI.
Fun fact: OpenAI a construit atunci un marcaj de text funcțional, dar a ales să nu-l lanseze. „Probabil” a ajutat în această decizie și faptul că aproape 30% dintre utilizatori spuneau că ar folosi ChatGPT mai puțin. La 1 octombrie 2026, OpenAI marchează imaginile și sunetul, iar textul apare la ei doar ca obiectiv.
Revenind la subiect... marcajul se aplică doar cuvintelor alese de Claude. Acolo unde există un singur răspuns corect, ca rezultatul unui calcul sau o linie de cod, nu se aplică, iar în pasajele factuale apare rar. Pentru că stă chiar în selecția de cuvinte, marcajul nu dispare dacă dai copy-paste, indiferent că-i direct sau prin screenshot. Nu conține informații despre tine, despre firma ta sau despre conversație și nu schimbă cine deține textul. Marcajul se aplică la nivel de model, deci peste tot: în aplicația Claude, în API, în Claude Code, Cowork și Claude Tag și prin partenerii de cloud, oriunde în lume.
Anthropic spune că l-a pus global pentru că nu are încă un mod sustenabil de a-l limita la UE, iar documentația nu pomenește nicio opțiune de dezactivare.
Unde este limitat marcajul
Un marcaj găsit e doar un semnal că textul a fost procesat de Claude la un moment dat, iar lipsa lui nu spune nimic sigur.
Claude poate doar să fi corectat, tradus sau rezumat un text scris de altcineva. Cei de la Anthropic recunosc că marcajul nu poate separa „Claude a scris” de „Claude a editat semnificativ”. Tot Anthropic scrie că lipsa marcajului nu înseamnă că textul e scris de om. Motivele sunt multe: modelele care încă nu marchează, editarea semnificativă, traducerea, amestecul cu alt text sau un pasaj prea scurt.
Sună destul de asemănător cu jocul de-a șoarecele și pisica de până acum cu detectoarele de AI (semi shady) de tip GPTZero.
Pentru noi, cei care scriem în română, cea mai practică diferență e cea dintre corectat și tradus. Când scrii tu textul și îi ceri lui Claude doar să repare virgulele sau diacriticele, marcajul nu are de ce să se prindă, pentru că aproape toate cuvintele rămân ale tale. Când scrii în română și îi ceri lui Claude să traducă pentru un client din afară, traducerea e marcată integral, pentru că fiecare cuvânt din ea e ales de Claude. Aici Anthropic este mai strict decât AI Act: ghidul Comisiei pe articolul 50 trece traducerile făcute cu AI la editarea standard, scutită de marcare.
Pentru fișiere, Claude folosește separat Content Credentials, adică standardul C2PA: o etichetă semnată, pusă în metadate. O primesc imaginile și, prin API, video-urile și fișierele audio generate de Claude.
PDF-urile, documentele Office și fișierele text rămân nesemnate, iar eticheta de acest tip dispare oricum la screenshot, conversie sau resalvare.
Verificarea fișierelor e publică și gratuită, prin Claude Content Checker - doar că e total diferită de verificarea Watermark-ului pe text.
Cine poate citi Watermark-ul Claude și cât de sigur e rezultatul?
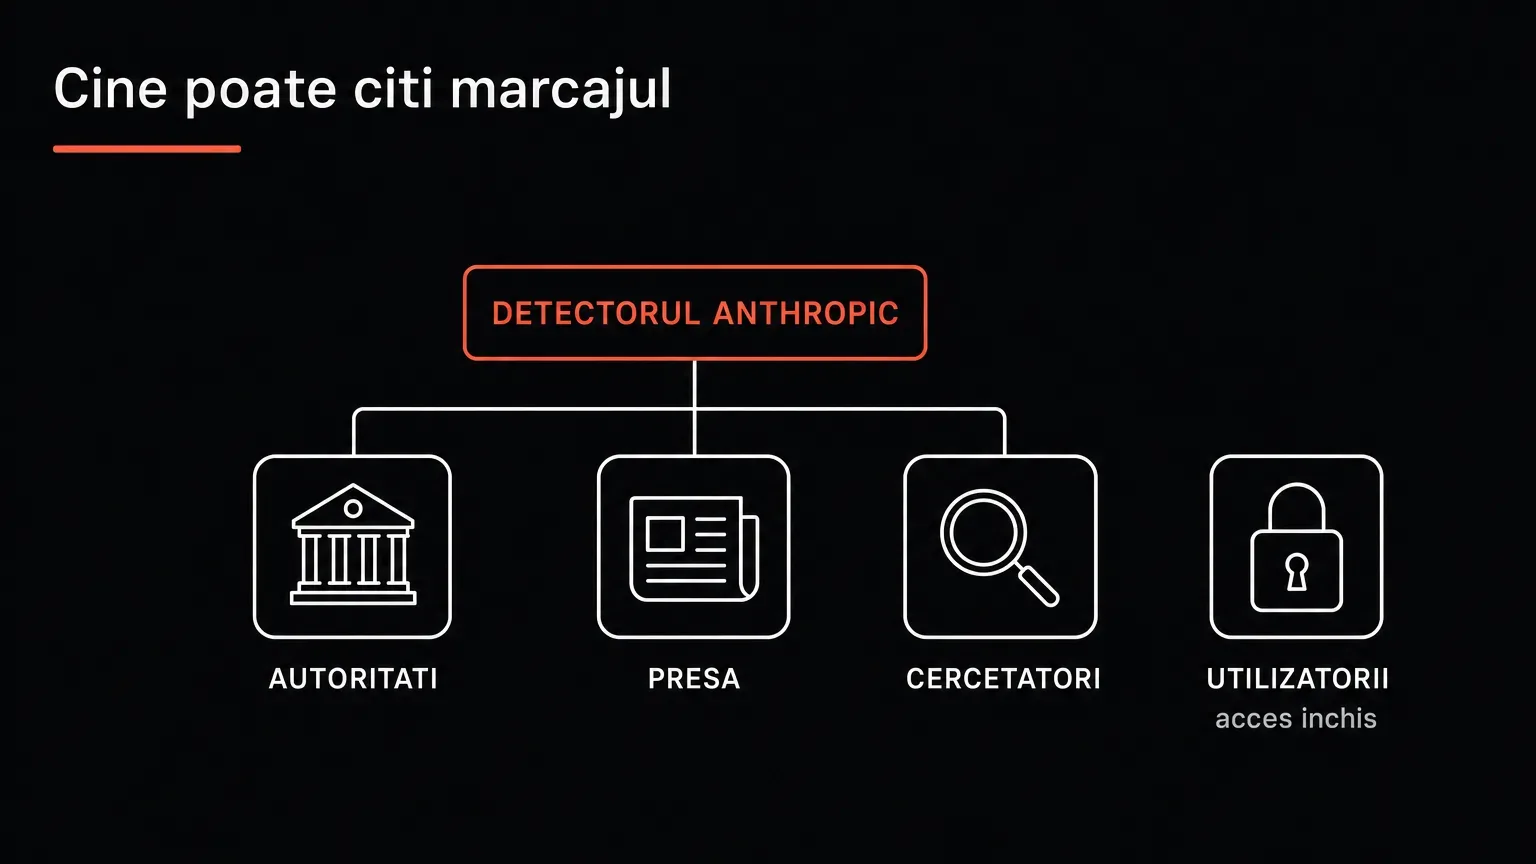
La scrierea acestui articol, marcajul Claude poate fi citit de către Anthropic și organizațiile eligibile admise în private preview: autorități, poliție, presă, fact-checkeri, cercetători independenți, instituții de educație, organizații ale societății civile din UE și firmele obligate să verifice marcajul. Pentru tine, pentru clientul tău sau pentru un profesor, accesul rămâne deocamdată închis. Anthropic n-a publicat pragul de decizie, rata de erori sau performanța pe limba română. N-aș fi deloc surprins să aibă o acuratețe mult mai mică decât în engleză (Claude având oricum problemuțe cu limba noastră).
Detectorul e în private preview
Detectorul Anthropic pentru text funcționează din 1 septembrie ca API în private preview, cu acces pe bază de cerere.
Cererea se face printr-un formular al Anthropic, care îți cere o organizație pe Claude Platform, cu rol de administrator, și scopul pentru care vrei acces. În august, mesajul suna altfel: un purtător de cuvânt Anthropic spunea pentru Business Insider că pregătesc un API gratuit, prin care utilizatorii și terții să verifice singuri textele.
Codul de practică european privind transparența conținutului generat cu AI, semnat de circa 190 de organizații, printre care Anthropic, le permite semnatarilor să limiteze detecția pentru text la „verified expert end-users”, pentru că pe text rezultatele pot fi înșelătoare sau cu încredere scăzută. Tot Codul cere ca restricția să fie limitată în timp, ca detecția să fie gratuită și ca detectoarele să devină interoperabile până pe 2 februarie 2027.
Situația e la fel la toți furnizorii. Pangram, una dintre firmele care vând detectoare de text AI, nota pe 14 septembrie că nicio companie de AI nu lansase public un detector de watermark pentru text. Portalul Google de verificare acceptă imagini, video și audio, OpenAI nu are încă ce citi pe text, iar Turnitin, GPTZero sau Pangram lucrează cu clasificatoare de stil, fără cheia vreunui furnizor.
Nici Google Search n-are cum să citească marcajul Claude, pentru că n-are cheia Anthropic. Documentația lui spune de ani buni că folosirea potrivită a AI-ului nu încalcă regulile, iar ce penalizează, conform politicilor de spam, sunt paginile făcute în masă, fără valoare pentru utilizator, indiferent cum au fost produse.
Apropo, dacă dai de un site care promite să-ți spună gratuit dacă textul tău are watermarkul Claude, fără cheia Anthropic, el ghicește stilul. Andrea Saez a arătat, chiar în ziua în care vestea a ajuns în presă, cum un astfel de detector construit naiv dă semnale false convingătoare pe un text scris de om, din cauza perechilor de cuvinte care se repetă firesc în engleza de zi cu zi.
Lungimea contează, doar că pentru română nu prea există măsurători
Detecția are nevoie de text cât mai mult. Iar asta înseamnă că pe un hook sau pe un caption e slabă, dar pe un articol lung semnalul devine solid.
Codul european consideră foarte scurt un text sub 200 de tokeni și nu cere marcaj acolo. În română, 200 de tokeni înseamnă un pic sub 150 de cuvinte, deci hook-urile, titlurile și caption-urile scurte stau sub acest prag.
Un hook tăiat dintr-un răspuns lung poartă marcajul Claude, doar că e prea scurt ca să fie judecat de unul singur. Pe texte mai lungi, o evaluare independentă publicată în septembrie, făcută pe versiunea open-source a SynthID-Text, a prins marcajul în 39% din textele de 200 de tokeni și în 56-59% din cele de 400, la o rată de 1% alarme false. Configurația Claude nu e publică, deci cifrele îți dau doar ordinul de mărime.
Pe română n-am găsit nicio măsurătoare publică, nici de la Anthropic, nici din cercetare. Google a raportat rezultate bune pe opt limbi, fără română, iar un studiu din august pe 11 limbi, tot fără română, arată diferențe între familii de limbi și praguri de alarmă falsă care nu se țin de la o limbă la alta fără recalibrare. Anthropic n-a publicat nici rata de alarme false, nici procedura prin care contești un rezultat, deci un verdict pe un text în română se sprijină azi pe o calibrare pe care n-o poate verifica nimeni din afară.
Ce face de fapt tool-ul viral de watermark removal?
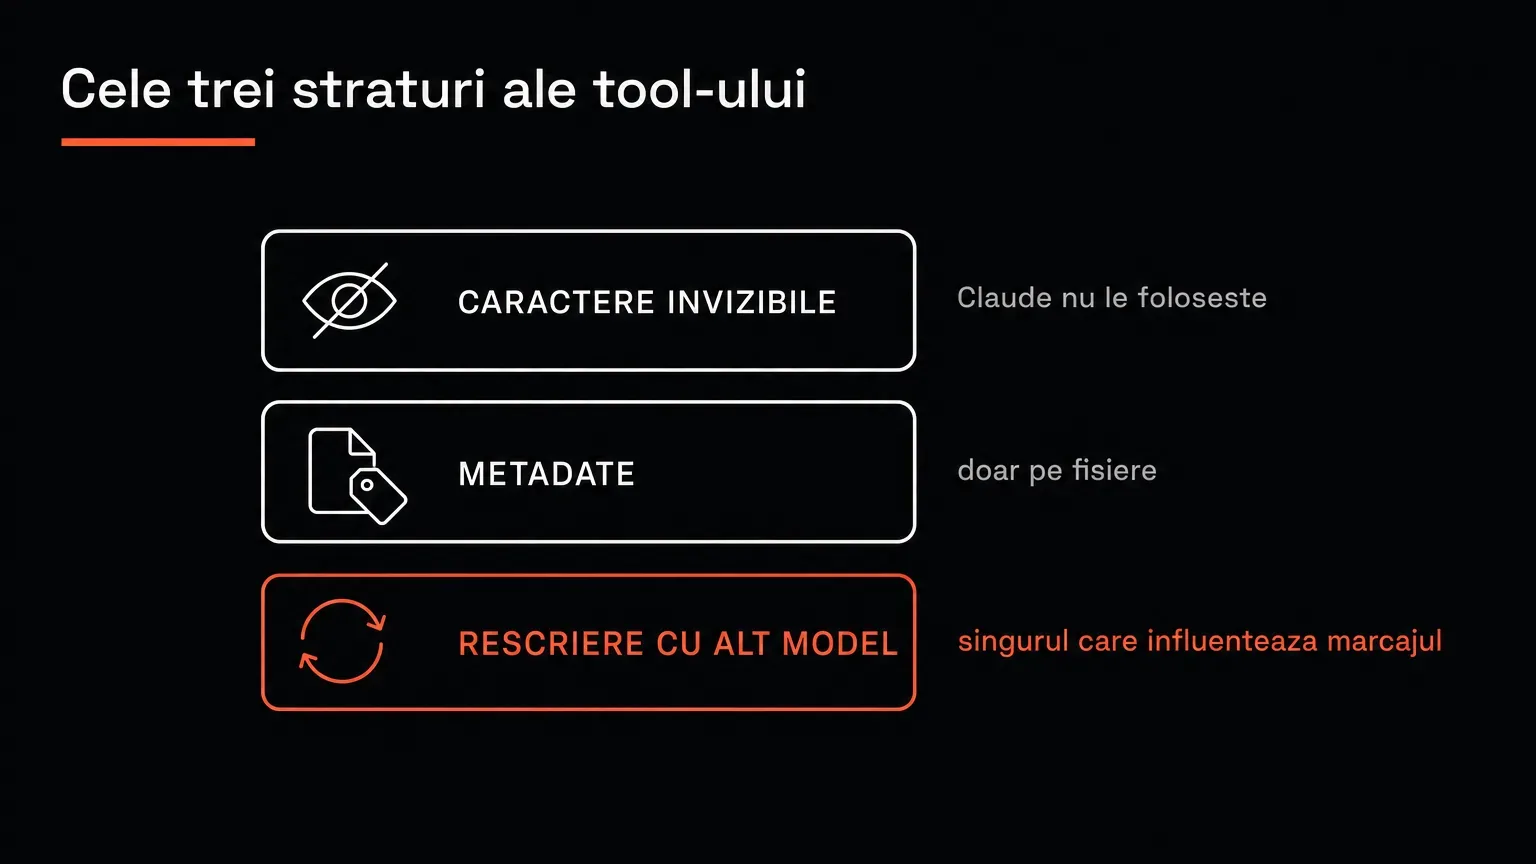
Tool-ul watermarks-remover, care a devenit viral peste noapte, lucrează pe trei straturi:
- Curăță caractere Unicode invizibile
- Șterge metadatele din fișiere
- Rescrie textul cu alt model decât Claude.
Doar al treilea strat atinge cu adevărat marcajul Claude (deși cel mai probabil îți și masacrează textul tău), iar documentația tool-ului recunoaște că azi niciun tool nu poate garanta rezultatul.
Ideea era pe marele internet încă din prima seară: la scurt timp după declarația Anthropic, Paul Graham, cofondatorul Y Combinator, scria pe X că un tool care reformulează textul și distruge marcajul ar fi o idee bună de startup.
A doua zi, Guillaume Meyer, un antreprenor din Paris, a scris prima versiune a watermarks-remover în vreo cinci ore, după relatarea Business Insider, și a publicat-o sub licență MIT. Nici măcar n-a fost primul: în aceeași zi apăruseră pe GitHub cel puțin alte două proiecte, iar unul dintre ele, al lui Michel Lévy-Provençal, se prezenta explicit ca demonstrație critică și avertiza că reușita nu se poate măsura până nu publică Anthropic detectorul.
Cel viral a fost însă al lui Meyer: 17.272 de stele pe 23 august, peste 23.000 la 1 octombrie și peste 2.600 de copii. Meyer spune public că e PRO atribuirii conținutului și ÎMPOTRIVA tehnicii de watermarking, iar proiectul se prezintă ca unealtă de confidențialitate pentru conținutul pe care îl deții.
Primul strat curăță caracterele Unicode invizibile, cum sunt spațiile de lățime zero. Asta-i partea pe care o poți verifica exact, pentru că tool-ul îți spune câte caractere a scos. Doar că la Claude n-are ce scoate. Pe lângă declarația explicită a Anthropic, două scanări independente au găsit zero caractere invizibile în textul lui Claude: Adrian Ulmeanu a trecut prin program 848.116 caractere din 12 sesiuni de lucru, iar echipa San Digital încă 457.045, de pe patru modele.
Al doilea strat șterge metadatele din fișiere, de la Content Credentials la etichetele EXIF și XMP. Funcționează, doar că aceleași metadate dispar oricum la primul screenshot sau la resalvare. Pentru magazinele online e chiar o capcană: Google Merchant Center cere tag-ul de metadate pe imaginile de produs generate cu AI și cere explicit să nu fie șters.
Al treilea strat e singurul care influențează marcajul Claude. Rescrie textul cu alt model, local sau prin API, iar în documentație exemplul e DeepSeek. Tehnica funcționează în laborator. Pe o reimplementare open-source a SynthID-Text, cu altă cheie decât a lui Claude, benchmark-ul publicat de autor arată marcajul șters în circa 62% din texte la o rescriere moderată și în toate textele la una agresivă.
Natzir Turrado a replicat și el SynthID-Text, cu cheie proprie, și l-a atacat pe un laptop: curățarea de caractere invizibile a lăsat detecția la 100%, iar o parafrazare cu un model mic a coborât-o la 5% în engleză și la 38% în spaniolă. Pe detectorul real al lui Claude, până la 1 octombrie, nimeni n-a publicat vreun test.
Autorul scrie și dezavantajul super transparent: orice rescriere înlocuiește alegerile tale de cuvinte cu ale modelului care rescrie și îți aplatizează tonul, vocea și precizia. Benchmark-ul lui arată că și la cel mai mic nivel de rescriere s-a schimbat jumătate sau mai mult din formulări. Tot în README, Meyer pune o întrebare incomodă pentru oricine cumpără un astfel de serviciu: „If the plan is to rewrite the text with a cheaper model anyway, why pay for a premium model in the first place?”
Unde s-a cam pierdut nuanța dezbaterii
README-ul aplicației spune din prima că rescrierea e „best-effort” și că „no tool can honestly certify” rezultatul, doar că atunci când unealta s-a viralizat, distribuția a transformat-o într-o rețetă sigură de ștergere watermark.
Meyer însuși a lansat tool-ul pe X cu promisiunea că șterge și marcajele statistice de pe text, iar a doua lui postare din aceeași seară a trecut de 2,4 milioane de vizualizări. De acolo, totul a mers previzibil... Un ghid promovat cu „comentează WATERMARK” promitea un setup de cinci minute: descarci zip-ul și îl urci ca skill în Claude. Numai că, de pe 14 august, skill-ul nu mai conține deloc cod de curățare („The skill ships no code”) și are nevoie de un serviciu pornit local, pe care ghidul nu-l pomenește. Ghidul recunoaște, de altfel, că tool-ul nu poate dovedi că a funcționat.
Cine a mers până la capăt a avut surprize. Mai mulți utilizatori au trecut textul rescris prin Pangram și au primit tot 100% AI, iar autorul le-a explicat, corect, că Pangram caută semnele de text generat și n-are acces la marcaj. În cel puțin două cazuri raportate public, Claude a refuzat să ruleze skill-ul, pe motiv că ar ocoli un mecanism de transparență.
Humanizerele comerciale au sărit și ele în trend. Își laudă rezultatele pe GPTZero, Turnitin sau Pangram, adică pe clasificatoare de stil care n-au cheia Anthropic, iar un site promite text scris 100% de om și nedetectabil, deși descrie doar ștergerea caracterelor invizibile și a liniilor lungi de pauză.
În presa noastră, titlurile au mers pe același trend. Pe 11 august, un titlu anunța că textele scrise cu Claude devin detectabile, cu trei săptămâni înainte de primul model marcat și fără vreun detector disponibil. Pe 7 septembrie, un altul anunța că watermarkul fusese deja spart, deși articolul de sub titlu explica, corect, că tool-urile lucrează pe principiul celei mai bune încercări.
Din fericire, există și creatori care au pus limitele în față de la început. Un editorialist Forbes scria pe 13 august că marcajul arată doar că s-a folosit Claude și lasă deschisă întrebarea despre autor, iar pe LinkedIn o creatoare cu peste 200.000 de urmăritori a explicat direct că marcajul se șterge doar rescriind practic tot.
Un skill te expune la aceleași riscuri ca orice alt software
Un skill instalat în Claude Code sau în Cowork lucrează cu accesul agentului tău, deci se instalează cu aceeași grijă ca orice program.
Documentația Anthropic îți spune explicit să folosești skill-uri doar din surse de încredere și să le tratezi ca pe instalarea unui software. Cifrele arată de ce. Un audit Snyk din februarie 2026 pe 3.984 de skill-uri publice a găsit probleme de securitate la 36,8% dintre ele și 76 de payload-uri malițioase confirmate, un studiu academic pe 31.132 de skill-uri a găsit vulnerabilități la 26,1%, iar Koi Security a numărat 341 de skill-uri malițioase pe o singură piață, cele mai multe livrând un malware care fură parole și date.
Proiectul original e construit prudent. Plugin-ul lui instalează un hook care rulează după fiecare fișier scris de agent, dar implicit doar raportează ce marcaje găsește, iar trimiterea textului spre un server extern cere activare explicită. Riscul real stă în zip-ul primit în DM după un „comentează WATERMARK”, care poate fi oricare dintre cele peste 2.600 de copii ale repo-ului sau o clonă cu nume aproape identic.
Poți ascunde marcajul scriind în vocea ta?
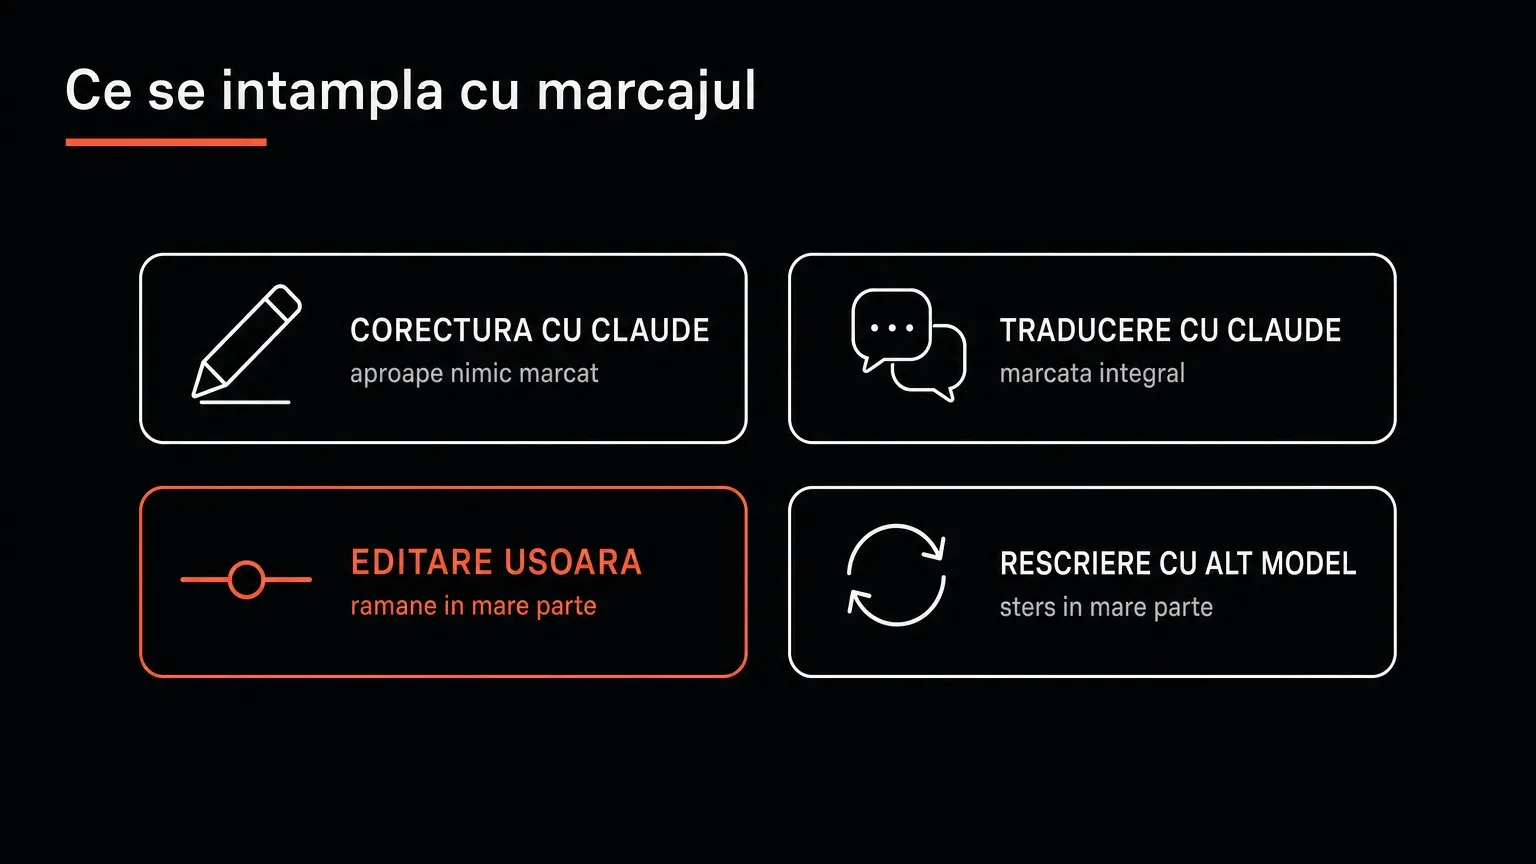
Oficial, vocea ta (personalizarea), promptul bun și editarea ușoară nu înlătură marcajul. Semnalul scade doar în măsura în care cuvintele finale sunt scrise sau rescrise efectiv de tine, iar dacă îi ceri lui Claude să rescrie textul „în vocea ta”, primești un text marcat din nou.
Anthropic scrie că editarea ușoară probabil nu elimină complet marcajul, iar o rescriere completă, în care e înlocuit fiecare cuvânt, îl elimină. Autorul tool-ului de removal e și mai direct: „Shuffling paragraphs, changing headings, or light touch-ups barely move the signal.” În cercetare, pe o schemă înrudită, marcajul a rămas detectabil chiar după parafrazarea făcută de oameni care încercau intenționat să-l scoată, în medie după vreo 800 de tokeni de text (Kirchenbauer et al., ICLR 2024).
Pentru un flux în care Claude scrie cea mai mare parte, iar omul ajustează la final, asta înseamnă că textul publicat poartă, foarte probabil, marcajul. Iar un skill de removal care lasă rescrierea chiar pe seama lui Claude produce, după aceeași logică a Anthropic de la traduceri, un text marcat din nou. De aceea documentația tool-ului cere explicit ca rescrierea să se facă cu alt model decât cel care pare să fi scris textul.
Am să las la final perspectiva mea legată de acest aspect, pentru că mi se pare cel mai dubios din tot update-ul.
Ce se întâmplă cu un text generat de Claude, scenariu cu scenariu
Marcajul este puternic acolo unde Claude a ales cele mai multe cuvinte și este mai slab acolo unde cuvintele finale sunt ale tale sau ale altui tool. Tabelul de mai jos abordează situațiile tipice din munca unui marketer, pe baza a ce spune Anthropic și a ce arată cercetarea pe implementările open-source ale aceleiași tehnici.
| Ce faci | Ce se întâmplă cu marcajul | Îl găsește cine are acces la detector? |
|---|---|---|
| Hook sau caption de 15-40 de cuvinte, scris de Claude | Poate exista, dar textul e mult sub pragul de 200 de tokeni | Nu |
| Newsletter de 800 de cuvinte scris de Claude din notițele tale, cu retușuri ușoare | Rămâne, în mare parte | Probabil da |
| Același newsletter, rescris de tine frază cu frază | Este slab | Incert, depinde de lungime și de cât a rămas neatins |
| Textul tău, corectat de Claude la gramatică și punctuație | Nu există nimic care să declanșeze watermark | Nu |
| „Rescrie-l în vocea mea”, cerut lui Claude | Marcaj nou, pe tot textul | Da, mai ales pe text lung |
| Text scris de Claude direct în română | Prezent | Da, doar că nu a fost măsurat public pentru română |
| Articolul tău în română, tradus în engleză de Claude | Marcaj pe toată traducerea | Da, pe text lung |
| Text scris de Claude, tradus apoi cu DeepL sau Google Translate | Watermark-ul dispare în mare parte | Cel mai probabil, nu |
| Două paragrafe scrise de Claude într-un articol propriu de 1.500 de cuvinte | Watermark-ul este diluat | Ratat pe tot textul, posibil de găsit pe bucăți mai mici |
| Text trecut printr-un humanizer bazat pe alt model | Șters în mare parte, cu vocea cu tot | Neverificat public pentru Claude |
Tabelul poate să-ți dea o direcție, dar după cum spuneam mai sus, pragurile exacte ale lui Claude nu sunt publice, iar cifrele din cercetare vin de pe implementări cu alte chei și alte setări.
Unde contează totuși vocea ta
Vocea ta contează la detectoarele de stil, gen GPTZero, Turnitin sau Pangram, care ghicesc textul generat după tipare și funcționează complet separat de watermark.
Anthropic explică singură diferența în FAQ-ul despre marcaj: detectoarele comerciale caută tipare de stil, iar printre exemplele date sunt fix construcția de tipul „nu e X, e Y” și folosirea excesivă a unui anumit cuvânt. Regulile de voce, fără construcții șablon și fără ticurile care trădează textul generat, te ajută în fața acestor detectoare. Dar marcajul nu ține cont de ele.
Detectoarele de stil au și reputația pe care o merită. Ghidul ASE din martie 2026 privind folosirea inteligenței artificiale generative le numește „nefiabile”, de natură probabilistică și fără valoare probatorie. Iar oamenii „prinși cu AI-ul în sac” în România au fost prinși, până acum, altfel. În august, prefectul de Argeș a trimis presei un comunicat cu tot cu răspunsul chatbotului rămas deasupra textului. L-a dat de gol un copy-paste grăbit.
Ce înseamnă asta pentru afacerea ta? Vocea ta te ferește de impresia de text generic, iar impresia asta contează pentru cititori și clienți mult mai mult decât un marcaj pe care ei nu-l pot citi.
E legală ștergerea watermarkului AI din textul tău?
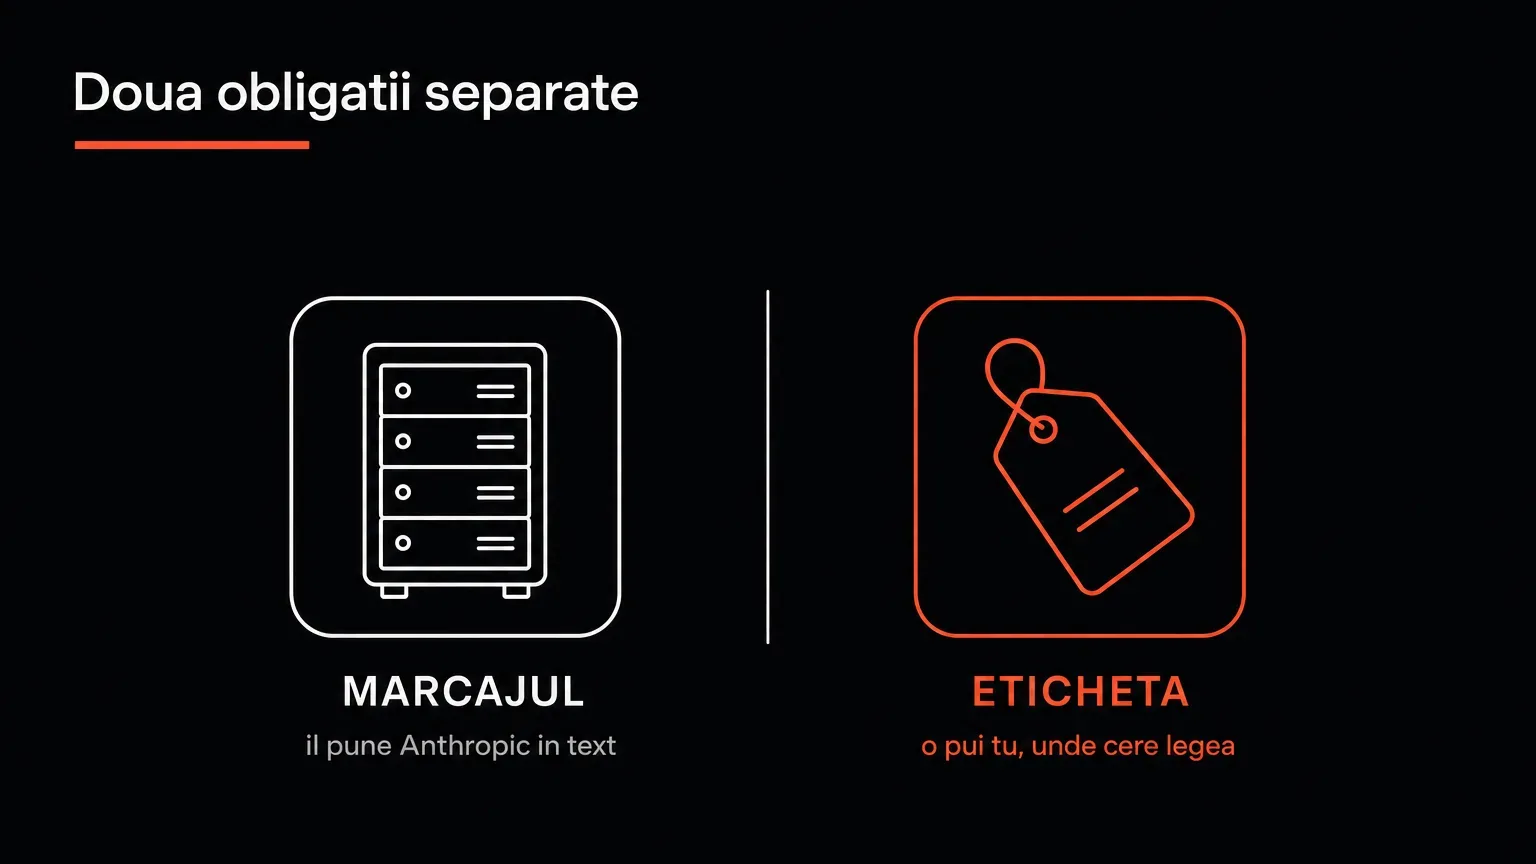
Față de AI Act, da. Legea pune obligația de marcare pe furnizorul de sistem AI, adică pe Anthropic în cazul Claude, iar riscurile tale reale sunt contractuale și, la textele de interes public, țin de eticheta pe care legea ți-o cere oricum.
Ce spun legea, Codul și termenii furnizorilor
Articolul 50 alineatul (2) din AI Act spune că „furnizorii de sisteme de IA, inclusiv de sisteme de IA de uz general, care generează conținut sintetic în format audio, imagine, video sau text, se asigură că rezultatele sistemului de IA sunt marcate într-un format prelucrabil automat și detectabile ca fiind generate sau manipulate artificial”. Ghidul Comisiei precizează că obligația privește sistemele, adică aplicațiile și API-urile construite peste modele. Dacă îți construiești pe API un chatbot sau un tool și îl pui pe piață sub numele tău, furnizorul devii tu, cum am explicat în articolul despre AI Act pentru marketeri.
În articolul 50 și în ghid nu există nicio interdicție adresată celui care folosește textul. Codul de practică le cere semnatarilor să interzică, prin politica de utilizare, termeni sau documentație, „the intentional removal of or tampering with metadata markings”, adică ștergerea intenționată a metadatelor de proveniență din fișiere. Watermarkul din text nu apare în clauza asta, iar la 1 octombrie termenii publici Anthropic nu pomeneau deloc watermarkul. Tot Codul le interzice semnatarilor să promoveze tool-uri făcute ca să ocolească marcajele.
Ce găsești în termeni e mai vechi și ține de felul în care folosești textul. Politica de utilizare Anthropic interzice să te dai drept om prezentând rezultatele ca fiind generate de om și să plagiezi sau să predai lucrări făcute cu AI fără permisiunea sau atribuirea cuvenită. OpenAI merge mai departe și interzice explicit, în documentația API, interogările repetate făcute ca să ocolești sau să ștergi un watermark.
În China, regula e mult mai dură. Din 1 septembrie 2025, regulile de etichetare interzic oricărei organizații și oricărei persoane să șteargă sau să ascundă cu rea-credință etichetele conținutului generat și interzic și furnizarea de unelte pentru asta. Un tool ca watermarks-remover ar fi acolo explicit ilicit. UE a pus obligația pe furnizor și l-a lăsat pe utilizator liber, cel puțin în fața legii.
Dreptul de autor e un teren separat de AI Act. Legea 8/1996 pedepsește, la articolul 199 alineatul (2), înlăturarea fără drept, în scop comercial, a informațiilor electronice privind regimul drepturilor de pe opere protejate. Marcajul Claude de pe textul tău foarte probabil nu intră aici, pentru că nu e pus de un titular de drepturi. Creditele și metadatele C2PA puse de un fotograf sau de alt autor pe opera lui sunt însă altă poveste, iar ștergerea lor dintr-un material folosit comercial te poate costa. Pentru contractele cu clauze despre AI sau cu promisiunea „scris de om”, o discuție cu avocatul tău face mai mult decât orice tool.
Capcana pentru textele de interes public
Pentru un articol sau un newsletter de interes public, un remover rulat după aprobare îți anulează scutirea de etichetă pe care ți-o dă legea.
Din 2 august 2026, textul generat cu AI pe teme de interes public, cum sunt legile, sănătatea publică sau evoluțiile economice și financiare, scapă de eticheta „generat cu AI” doar dacă trece printr-o revizie umană reală și dacă un om își asumă public răspunderea editorială, cum am detaliat în articolul despre AI Act. Ghidul Comisiei adaugă, la paragraful 136, o frază care contează direct aici: „Any substantive AI intervention occurring after the human review or editorial control process has taken place will therefore cause the exception to become void.”
Un remover care rescrie textul cu alt model, după ce l-ai aprobat, e fix o astfel de intervenție. Pierzi scutirea și ai nevoie de etichetă, deci ai plătit cu vocea sau calitatea textului, doar ca să ajungi într-o situație mai proastă decât înainte.
Watermarkul pus de Anthropic și eticheta pusă de tine sunt obligații separate. Ghidul spune explicit, la deepfake-uri, că utilizatorul nu se poate baza pe marcajul tehnic pus de furnizor. Cu sau fără marcaj în text, obligațiile tale de etichetare rămân aceleași.
Ce faci concret, ca marketer
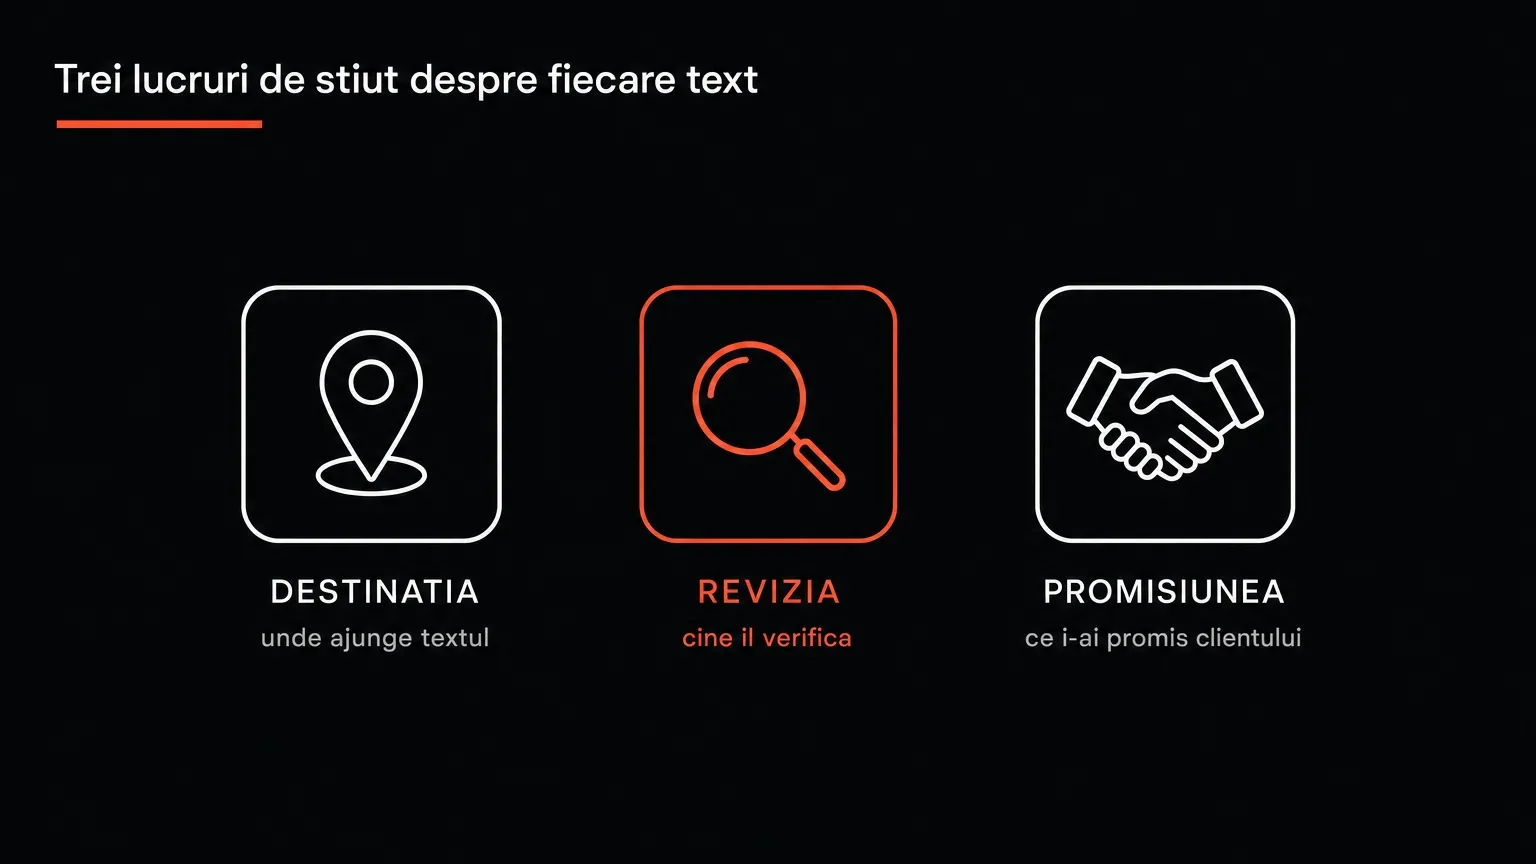
Ca marketer, ai nevoie de trei lucruri: să știi unde ajunge fiecare text, cine îl verifică și ce i-ai promis clientului.
Checklistul unui marketer care scrie cu Claude
Checklistul de mai jos pornește de la destinația textului și se termină cu tool-urile din feed. Primii trei pași te protejează în fața clienților și a legii, restul țin de igiena procesului:
- Destinația textului. Textul comercial, adică reclamele, ofertele și descrierile de produs, nu cere etichetă după AI Act, cu excepția afirmațiilor despre sănătate, siguranță sau sustenabilitate. Textul de interes public cere revizie reală și nume asumat, altfel primește etichetă.
- Revizia dinaintea publicării. Fact-check pe cifre, nume și citate, făcut de cineva care se pricepe, și nicio rescriere cu AI după aprobare.
- Ce i-ai promis clientului. Dacă un contract spune „scris de om” sau interzice AI-ul, problema e promisiunea, cu sau fără marcaj. O clauză clară despre folosirea AI te protejează mai bine decât orice tool de ștergere.
- Traducerile. Dacă livrezi traduceri făcute cu Claude, îi spui clientului, pentru că textul tradus e marcat integral.
- Imaginile de produs. Păstrezi metadatele pe imaginile generate cu AI, mai ales pe cele urcate în Google Merchant Center.
- Evidența procesului. Cine a generat, cine a verificat, cine a aprobat. Te acoperă la o reclamație și îți disciplinează producția.
- Tool-urile din feed. Înainte să instalezi ceva, verifică sursa primară, asigură-te că înțelegi mecanismul, ce acces primește tool-ul în sistemele tale și de unde vine, de fapt, zip-ul final pe care îl instalezi.
Ce poți ignora legat de watermark-ul Claude
Lista completă e mai jos:
- Curățarea caracterelor invizibile din textele Claude, pentru că n-are ce curăța.
- Humanizerele plătite care promit text nedetectabil. Scorurile lor vin din detectoare de stil, iar dacă rescriu destul cât să atingă marcajul, îți iau și vocea.
- Grija pentru hook-uri, titluri și caption-uri scurte, prea scurte ca să fie judecate singure.
- Frica de Google, care n-are cheia Anthropic și judecă valoarea paginii.
- Frica de a fi identificat, pentru că marcajul nu conține date despre tine sau despre firma ta.
- Detectoarele de stil folosite ca verdict, pe textele tale sau pe ale altora.
Întrebări frecvente
Ce texte scrise cu Claude poartă watermark?
Textele generate cu modelele Claude care aplică deja regula. La 1 octombrie 2026, acestea erau Fable 5.1, Fable 5, Mythos 5.1, Opus 5.5, Opus 5, Opus 4.8, Sonnet 5.5 și Sonnet 5, pe toate suprafețele și la partenerii de cloud. Pe Amazon Bedrock, marcajul pentru Fable 5, Opus 4.8 și Sonnet 5 ajunge complet până pe 12 octombrie. Restul modelelor primesc marcajul treptat, toate până pe 2 decembrie 2026. În august, după documentația Anthropic, niciun model Claude nu marca încă textul.
Cine poate verifica dacă un text are watermarkul Claude?
Anthropic și organizațiile eligibile admise în private preview din 1 septembrie 2026: autorități, poliție, presă, fact-checkeri, cercetători independenți, instituții de educație, organizații ale societății civile din UE și firmele obligate să verifice marcajul. Pentru utilizatorii obișnuiți, clienți sau profesori, accesul individual rămâne închis, iar detectoarele de stil, ca GPTZero sau Pangram, lucrează fără cheia Anthropic.
Se poate șterge watermarkul Claude?
Da, prin rescrierea aproape integrală a textului, făcută de tine sau de alt model decât Claude. Editarea ușoară, schimbarea titlurilor sau curățarea caracterelor invizibile nu influențează marcajul. În laborator, rescrierea cu alt model șterge marcajul în majoritatea cazurilor, dar cu prețul vocii tale. Iar rezultatul pe detectorul real al lui Claude nu-l poți verifica nici tu și nici cei care vând tool-urile.
Watermarkul dovedește că un text e scris cu AI?
Un marcaj găsit e doar un semnal că textul a trecut, probabil, prin Claude la un moment dat, fie că l-a scris, fie că l-a corectat, tradus sau rezumat. Marcajul nu conține informații despre utilizator, iar lipsa lui nu înseamnă că textul e scris de om.
E legal să șterg watermarkul din textul meu?
Față de AI Act, da, pentru că legea pune obligația de marcare doar pe furnizorul de sistem AI. Rămân termenii furnizorilor, care interzic prezentarea rezultatelor ca fiind generate de om, și obligațiile tale de etichetare. La textele de interes public, o rescriere cu AI după aprobare anulează scutirea de etichetă.
Ce cred eu despre watermark și valul de removere
Cred că watermarkul Claude e un detaliu de infrastructură, iar valul de removere le-a vândut marketerilor o problemă pe care aproape că n-o au.
Marcajul se poate șterge, rescriind textul aproape integral cu alt model, doar că inevitabil o să plătești cu vocea (calitatea rezultatului) și nu poți verifica ce ai câștigat.
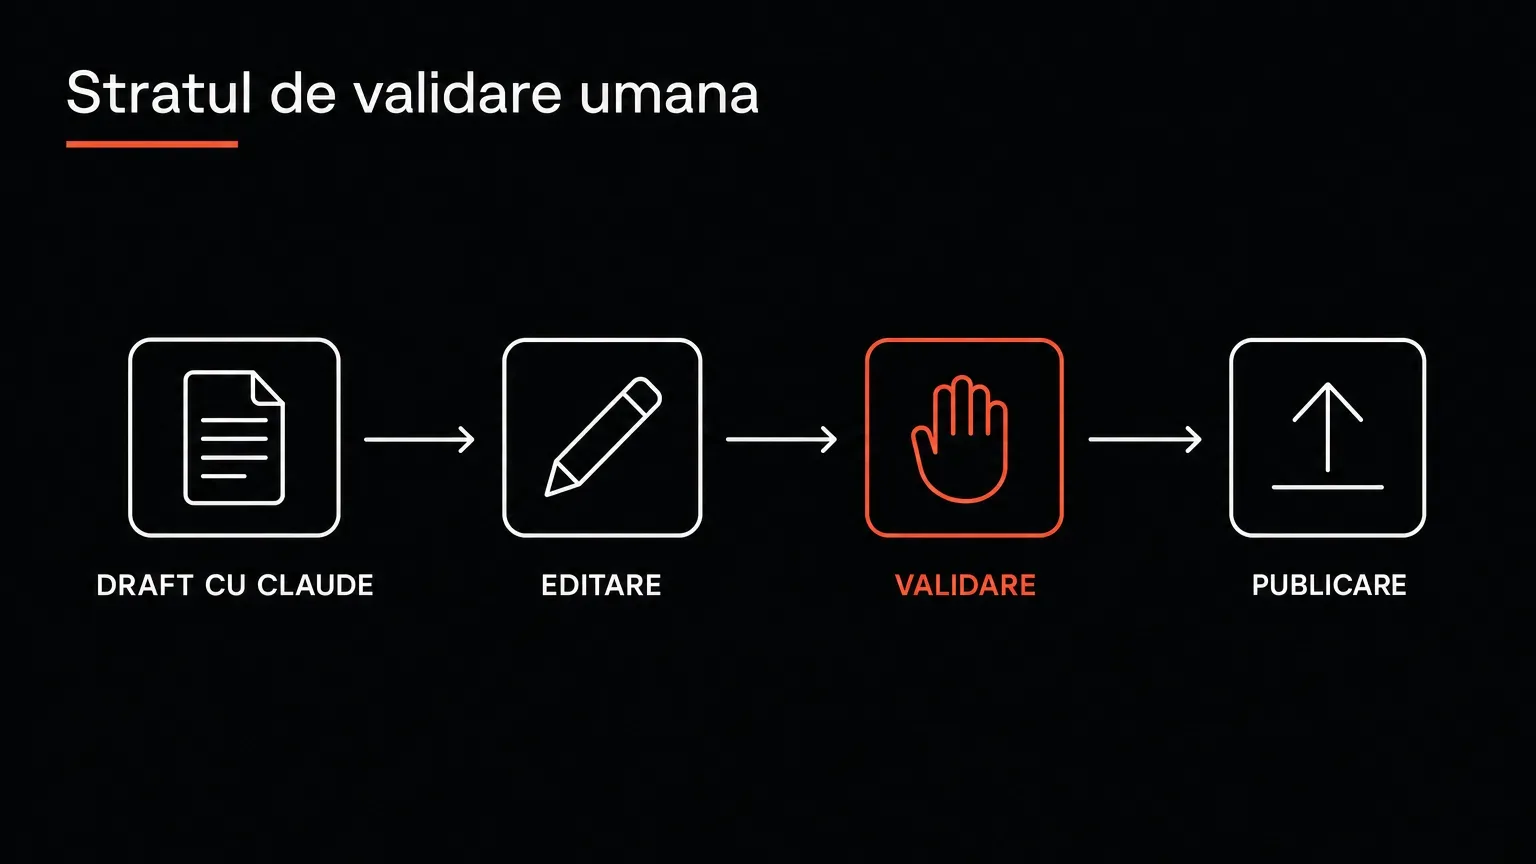
Eu predau și instalez la clienții mei sisteme de producție de content cu Claude, insistând mereu pe nevoia unui om care validează la final.
Tot research-ul îmi arată că editarea finală sau personalizarea nu va conta în cazul watermark-ului.
Deci textele scrise așa cu modelele noi vor fi cel mai probabil marcate.
Eu sunt împăcat cu asta și cred că și tu ar trebui să fii.
Stratul de validare umană e motivul pentru care un text se publică fără jenă, cu reputația intactă, iar răspunderea pentru ce public rămâne a mea, cu sau fără marcaj.
Așa, pe final, am și o dilemă personală legată de subiectul Claude Watermark pe care doar o las aici, urmând să vorbesc mai mult despre ea când vom putea și să o validăm.
Cei de la Anthropic spun că o editare ușoară sau folosirea personalizării (vocea ta) nu influențează prea mult watermark-ul.
În același timp, tot ei confirmă că marcajul se bazează pe alegerea înșiruirii cuvintelor.
Asta înseamnă că de acum Claude îmi va sabota intenționat vocea (propria mea înșiruire de cuvinte) pentru a proteja watermark-ul, generând intenționat un text de calitate mai slabă față de ce ar fi generat înainte de acest update?
Food for thought.
Responsabil editorial: Cristian Mezei, cristian@thrivenexus.ro.
Surse
Anthropic
- Anthropic, „How Claude marks AI-generated content”, centrul de ajutor Claude, publicată pe 10 august 2026, actualizată și consultată pe 1 octombrie 2026 support.claude.com
- Anthropic, „How Claude's text watermark works”, 14 august 2026, actualizată pe 1 septembrie 2026 anthropic.com
- Anthropic, anunțul Claude Fable 5.1 și Claude Mythos 5.1, 1 septembrie 2026 anthropic.com
- Documentația Claude, Content Credentials pe fișierele generate platform.claude.com
- Claude Content Checker claude.com
- Documentația Claude, Agent Skills platform.claude.com
- Anthropic, Usage Policy, în vigoare din 15 septembrie 2025 anthropic.com
Legislație și documente oficiale
- Regulamentul (UE) 2024/1689 (AI Act), versiunea consolidată la 27 iulie 2026, articolul 50 publications.europa.eu
- Regulamentul (UE) 2026/1744, Digital Omnibus pe AI publications.europa.eu
- Comisia Europeană, ghidul privind obligațiile de transparență din articolul 50, C(2026) 5054, 20 iulie 2026 digital-strategy.ec.europa.eu
- Comisia Europeană, Codul de practică privind transparența conținutului generat cu AI, 10 iunie 2026 digital-strategy.ec.europa.eu
- Comisia Europeană, „Strong backing for the Code of Practice on Transparency of AI-generated Content”, 31 iulie 2026 digital-strategy.ec.europa.eu
- Legea 8/1996 privind dreptul de autor și drepturile conexe legislatie.just.ro
- Administrația Spațiului Cibernetic din China, măsurile privind etichetarea conținutului generat cu AI, 14 martie 2025, în vigoare din 1 septembrie 2025 cac.gov.cn
- ASE București, ghidul privind utilizarea instrumentelor de inteligență artificială generativă, Hotărârea Senatului nr. 38 din 25 martie 2026 senat.ase.ro
Tool-urile de removal și securitatea skill-urilor
- Guillaume Meyer, watermarks-remover (README, SKILL.md, release-uri), GitHub, consultat pe 1 octombrie 2026 github.com
- watermarks-remover, benchmark-ul pe SynthID-Text github.com
- watermarks-remover, discuția despre verificarea cu Pangram github.com
- watermarks-remover, discuția despre refuzul lui Claude, 24 septembrie 2026 github.com
- Michel Lévy-Provençal, claude-watermark-cleaner, GitHub, 11 august 2026 github.com
- San Digital, auditul caracterelor invizibile din textul Claude github.com
- Adrian Ulmeanu, „Watermark Claude: ce șterge de fapt unealta virală de pe GitHub”, RoboMarketing, 16 august 2026 robomarketing.ro
- Natzir Turrado, testul pe SynthID-Text, 18 august 2026 natzir.com
- MaverickGPT, ghidul de ștergere a watermarkului Claude, august 2026 mavgpt.ai
- claudewatermark.com, pagina de prezentare, consultată pe 1 octombrie 2026 claudewatermark.com
- Pangram, „What is AI watermarking?”, 14 septembrie 2026 pangram.com
- Snyk, „ToxicSkills”, 5 februarie 2026 snyk.io
- Liu et al., „Agent Skills in the Wild”, arXiv, 15 ianuarie 2026 arxiv.org
- The Hacker News, cele 341 de skill-uri malițioase de pe ClawHub, 2 februarie 2026 thehackernews.com
- Megan Lieu, postarea despre ștergerea watermarkului Claude, LinkedIn, 16 septembrie 2026 linkedin.com
Platforme și alți furnizori
- Google Merchant Center, cerințele pentru conținutul generat cu AI support.google.com
- Google Search Central, „Google Search's guidance about AI-generated content”, 8 februarie 2023 developers.google.com
- Google Search Central, politicile de spam developers.google.com
- OpenAI, documentația API despre proveniența conținutului developers.openai.com
- OpenAI Help Center, semnalele de proveniență din conținutul generat de OpenAI help.openai.com
Presă
- TechCrunch, „Anthropic says it will watermark text generated by its AI models”, 11 august 2026 techcrunch.com
- Euronews, „EU compliance, delivered globally: Anthropic to watermark Claude's output worldwide”, 11 august 2026 euronews.com
- Business Insider, întrebările comunității tech despre watermark, 13 august 2026 businessinsider.com
- Business Insider, abonamentele anulate din cauza watermarkului, 14 august 2026 businessinsider.com
- Business Insider, valul de tool-uri de ștergere, 18 august 2026 businessinsider.com
- Dan Fitzpatrick, „Claude's Watermark Proves It Was Used, Not Who Wrote It”, Forbes, 13 august 2026 forbes.com
- Search Engine Journal, „OpenAI Scraps ChatGPT Watermarking Plans”, 5 august 2024 searchenginejournal.com
- Mobilissimo, textele scrise cu Claude și watermarkul, 11 august 2026 mobilissimo.ro
- Playtech, instrumentele care promit ștergerea watermarkului Claude, 7 septembrie 2026 playtech.ro
- Adevărul, comunicatul prefectului de Argeș, 24 august 2026 adevarul.ro
- Paul Graham, postarea de pe X din 10 august 2026 x.com
Cercetare
- Dathathri et al., „Scalable watermarking for identifying large language model outputs”, Nature 634, 23 octombrie 2024 nature.com
- Scott Aaronson, propunerea de watermarking statistic, 28 noiembrie 2022 scottaaronson.blog
- Kirchenbauer et al., „On the Reliability of Watermarks for Large Language Models”, ICLR 2024 arxiv.org
- Nemecek, Chaudhary și Ayday, „Watermarks Without Verification: AI Text Watermarking After the EU AI Act”, arXiv, 9 septembrie 2026 arxiv.org
- Nemecek et al., „Auditing Cross-Lingual Fairness in Language Model Watermarking”, arXiv, 20 august 2026 arxiv.org
- Andrea Saez, „Putting Claude's watermarking to the test”, 11 august 2026 dreasays.substack.com